Mô Hình AI Mới Nâng Cao Phát Hiện Tự Kỷ Qua Giọng Nói Sử Dụng Nhiều Đặc Trưng Âm Thanh

Phương Pháp Đổi Mới Trong Sàng Lọc Tự Kỷ Qua Phân Tích Giọng Nói
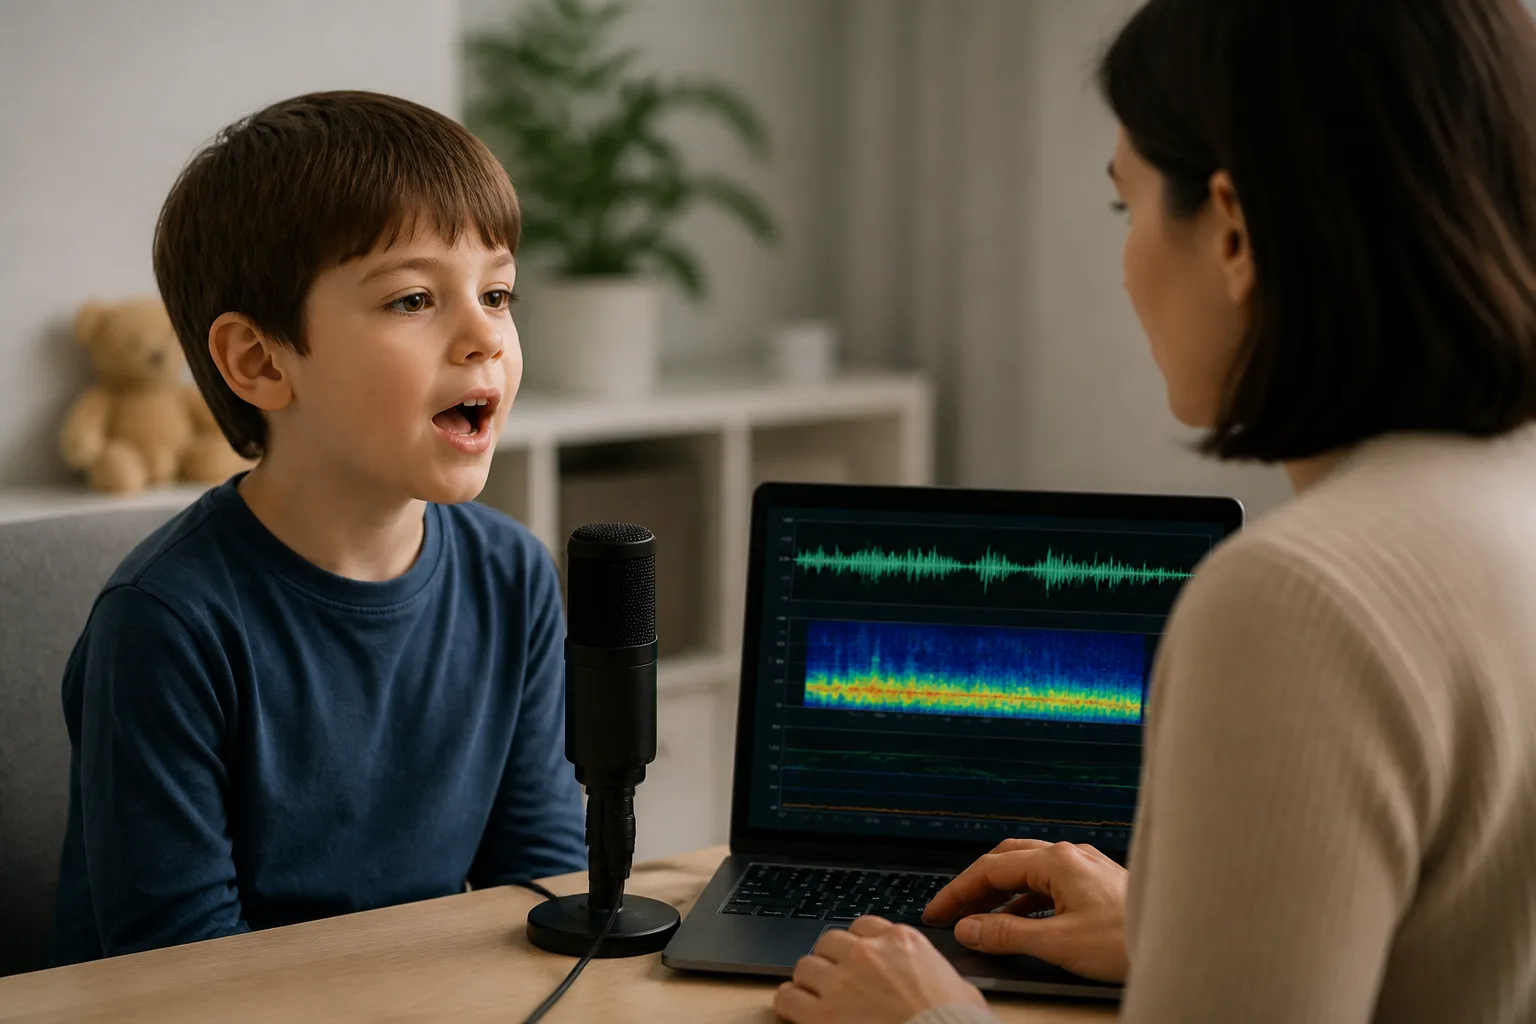
Các nhà nghiên cứu đã phát triển một hệ thống trí tuệ nhân tạo mới cải thiện khả năng phát hiện rối loạn phổ tự kỷ (ASD) bằng cách phân tích giọng nói của trẻ em sử dụng nhiều bộ đặc trưng âm thanh khác nhau. Phương pháp này nhằm cung cấp công cụ sàng lọc ASD sớm, không xâm lấn thông qua kỹ thuật phân tích giọng nói tiên tiến.
Mạng Lưới Chú Ý Đa Nhánh và Hợp Nhất (MBAFNet)
Hệ thống mới được gọi là Mạng Lưới Chú Ý Đa Nhánh và Hợp Nhất (MBAFNet), tích hợp nhiều biểu diễn âm thanh được huấn luyện trước — cụ thể là YAMNet và VGGish — nhằm nắm bắt các đặc điểm khác nhau của giọng nói. Khác với các phương pháp trước đây thường dựa vào một biểu diễn âm thanh duy nhất, MBAFNet xử lý từng biểu diễn riêng biệt qua các bộ mã hóa tích chập chuyên biệt. Các bộ mã hóa này trích xuất các mẫu thời gian ở nhiều quy mô khác nhau, sau đó được kết hợp thông qua cơ chế tự chú ý để mô hình hóa sự tương tác giữa các đặc trưng âm thanh khác nhau.
Cơ chế điều khiển trong mạng lưới sẽ cân nhắc động sự đóng góp của từng biểu diễn âm thanh trước khi đưa ra quyết định phân loại cuối cùng. Chiến lược hợp nhất chọn lọc này cho phép mô hình tận dụng thông tin bổ trợ từ các biểu diễn âm thanh đa dạng, giúp nâng cao độ chính xác trong phát hiện ASD.
Hiệu Suất và Đánh Giá
Mô hình được thử nghiệm trên tập dữ liệu CASD-SC, một bộ dữ liệu thiết kế dành cho phân tích giọng nói ASD, sử dụng giao thức đánh giá năm lần gập nghiêm ngặt đảm bảo không trùng lặp đối tượng giữa tập huấn luyện và kiểm tra. MBAFNet đạt độ chính xác 94,17%, vượt trội hơn tất cả các mô hình cơ sở và phương pháp tiên tiến trước đó được báo cáo trong tài liệu.
Ý Nghĩa Đối Với Gia Đình và Chuyên Gia Y Tế
Kết quả đầy hứa hẹn này cho thấy việc kết hợp nhiều biểu diễn âm thanh với kỹ thuật chú ý và hợp nhất tiên tiến có thể nâng cao công cụ sàng lọc tự kỷ dựa trên giọng nói sớm. Những công cụ như vậy có thể mang lại lựa chọn dễ tiếp cận và ít xâm lấn hơn để xác định trẻ em có thể cần được đánh giá lâm sàng thêm.
Hạn Chế và Hướng Phát Triển
Dù kết quả rất khả quan, các nhà nghiên cứu nhấn mạnh cần có sự xác thực rộng rãi hơn trên các nhóm dân cư và môi trường đa dạng trước khi công nghệ này được khuyến nghị sử dụng thường quy. Kết quả nghiên cứu hiện tại chỉ mang tính sơ bộ và cần được diễn giải thận trọng, vì các phương pháp phát hiện dựa trên giọng nói vẫn đang được nghiên cứu tích cực và không thể dùng làm chẩn đoán độc lập.
Để biết thông tin chi tiết hơn, vui lòng xem bài báo nghiên cứu gốc: Mạng Lưới Chú Ý Đa Nhánh và Hợp Nhất Cho Phát Hiện Tự Kỷ Qua Giọng Nói Sử Dụng Các Biểu Diễn Âm Thanh Đa Dạng.
Tải Về Hình Ảnh Trong Bài Viết Này